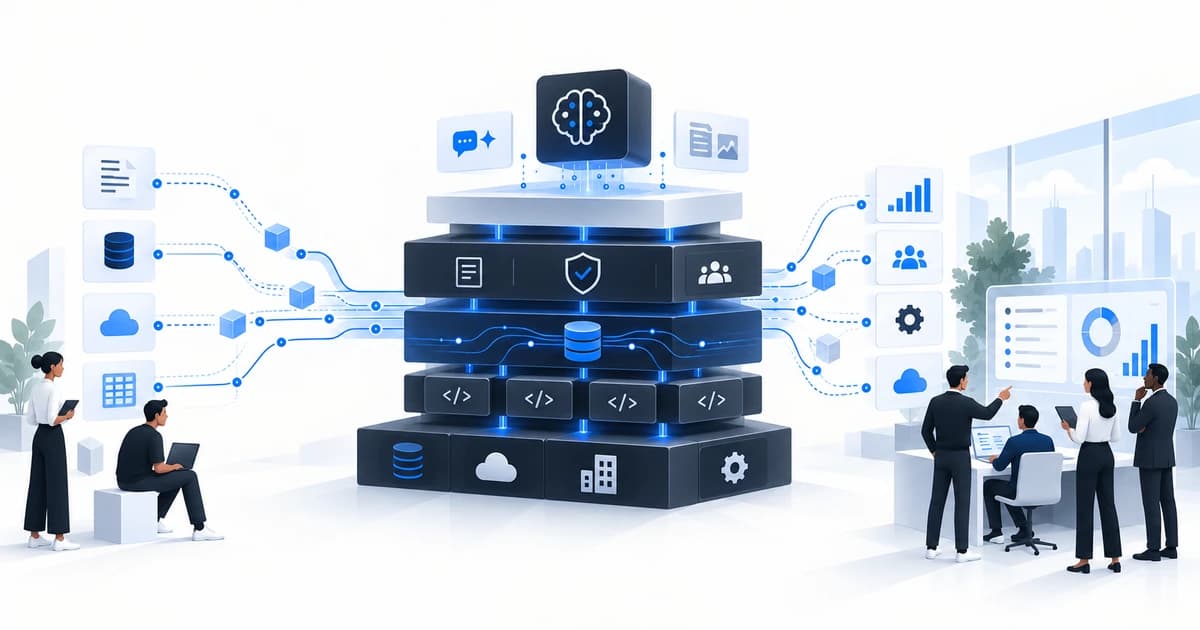
Phần dễ nhìn thấy nhất của một sản phẩm AI thường là mô hình. Phần tạo ra giá trị bền vững lại nằm ở những lớp phía dưới.
Khi một bản mẫu AI thất bại, đội ngũ thường nghĩ nguyên nhân là mô hình chưa đủ tốt. Trong môi trường doanh nghiệp, vấn đề sâu hơn thường nằm ở kiến trúc: hệ thống không định danh người dùng một cách ổn định, không lấy được dữ liệu hiện hành, không thực thi được hành động nghiệp vụ, không kiểm soát được quyền, hoặc không tái dựng được chuyện gì đã xảy ra sau một quyết định tự động.
Vì vậy, một kiến trúc sẵn sàng cho AI (AI-ready) bắt đầu từ bên dưới lớp mô hình.
1. API biến AI từ “trả lời” thành “hành động”
Một mô hình ngôn ngữ có thể nói nên làm gì. Hệ thống doanh nghiệp phải biết nó có được phép làm hay không.
Các sản phẩm AI hữu ích cần giao diện lập trình ổn định cho những hành động như:
- tạo/cập nhật khách hàng;
- kiểm tra tồn kho;
- tra cứu chính sách;
- tạo công việc;
- gửi phê duyệt;
- tạo báo giá nháp;
- đối soát thanh toán;
- chuyển ngoại lệ cho người chịu trách nhiệm.
Không có API hoặc ranh giới dịch vụ rõ ràng, đội ngũ thường phải tự động hóa những thao tác trình duyệt mong manh, hoặc cho mô hình can thiệp trực tiếp vào cấu trúc dữ liệu nội bộ. Cả hai cách đều khó quản trị khi quy mô tăng.
2. Dữ liệu cần có ngữ nghĩa, không chỉ cần truy cập được
Cho AI quyền đọc “toàn bộ dữ liệu công ty” không phải là chiến lược. AI cần biết bản ghi nào là mới nhất, ai sở hữu, ý nghĩa là gì và xử lý thế nào khi hai nguồn mâu thuẫn.
Một lớp dữ liệu tốt cần xác định:
- mã định danh chuẩn;
- hệ thống giữ vai trò nguồn dữ liệu gốc;
- độ mới của dữ liệu;
- ranh giới giữa các tenant và tổ chức;
- dấu thời gian và nhật ký truy vết;
- trạng thái “rỗng” và “chưa biết” được thể hiện rõ;
- thời hạn lưu trữ khi cần.
Với AI, việc thiết kế trạng thái dữ liệu đặc biệt quan trọng. Số 0, rỗng, chưa biết và lỗi không thể coi là một. Nếu truy vấn hỏng nhưng ứng dụng hiểu là “không có bản ghi”, AI agent có thể ra quyết định rất tự tin từ dữ liệu thực tế chưa từng được đo.
3. Định danh trở thành hạ tầng cho cả con người và máy
Khi AI bắt đầu gọi công cụ, nó hành xử gần giống một người dùng. Từ đó xuất hiện bài toán định danh mới: AI agent được phép làm gì, thay mặt ai, trong bao lâu và trong ngữ cảnh nào?
Nghiên cứu về bảo mật năm 2026 của Gartner nhấn mạnh định danh như một lớp hạ tầng cốt lõi, khi số lượng danh tính của máy và tác vụ tự vận hành tăng nhanh. Bài học thực tế là tránh dùng một bộ thông tin xác thực toàn quyền cho AI.
Nên ưu tiên phạm vi quyền rõ ràng, thông tin xác thực có thời hạn ngắn khi phù hợp, ngữ cảnh người dùng hoặc hệ thống rõ ràng, và nhật ký đầy đủ cho các hành động nhạy cảm.
4. Giám sát phải bao gồm cả hành vi kinh doanh
Giám sát truyền thống chỉ hỏi dịch vụ có đang chạy không. Sản phẩm AI cần thêm câu hỏi: hệ thống có đang ra quyết định hữu ích, đúng quyền và hợp lý về kinh tế không?
Dữ liệu giám sát nên bao gồm:
- các lệnh gọi công cụ và kết quả;
- phê duyệt hoặc từ chối của con người;
- nguồn dữ liệu được truy xuất;
- thay đổi mô hình và phiên bản;
- các nhóm lỗi;
- chi phí trên mỗi quy trình;
- tỷ lệ phải chuyển sang phương án dự phòng;
- tỷ lệ người dùng sửa lại kết quả.
Nhờ vậy, đội ngũ tối ưu không chỉ thời gian hoạt động liên tục mà cả chất lượng vận hành.
5. Kiến trúc nên tách thử nghiệm khỏi quyền hành động
Doanh nghiệp cần thử nghiệm nhanh, nhưng không nên để AI đang thử nghiệm làm thay đổi dữ liệu thật đang vận hành.
Nên tách:
- môi trường thử nghiệm và môi trường vận hành thật;
- quyền đọc và quyền ghi;
- tác vụ rủi ro thấp và tác vụ rủi ro cao;
- đề xuất và thực thi;
- hành động có thể hoàn tác và không thể hoàn tác.
Ranh giới rõ giúp đổi mới nhanh hơn, vì rủi ro đã được thiết kế từ trước.
6. Mô hình nên có thể thay thế được
Thị trường mô hình AI thay đổi rất nhanh. Nếu logic kinh doanh bị gắn cứng vào một nhà cung cấp, doanh nghiệp sẽ tự tạo ra sự phụ thuộc không cần thiết.
Không cần trừu tượng hóa đến mức cực đoan. Chỉ cần logic nghiệp vụ, phân quyền, trạng thái quy trình và quy tắc nghiệp vụ nằm ngoài mô hình, để có thể đổi mô hình mà không phải viết lại cả doanh nghiệp.
Gartner cũng nhấn mạnh API, dữ liệu và nền tảng kỹ thuật an toàn, sẵn sàng cho AI, là điều kiện để mở rộng giá trị của AI.
Bài kiểm tra mức độ sẵn sàng đơn giản
Trước khi triển khai thêm một tính năng AI, hãy hỏi:
- Hệ thống có xác định đúng người dùng hoặc AI agent không?
- Dữ liệu có mới, đúng phạm vi và truy vết được nguồn không?
- Hành động nghiệp vụ có được thực hiện qua API có kiểm soát không?
- Tác vụ rủi ro cao có thể yêu cầu phê duyệt không?
- Sau sự cố, có tái dựng được chuyện gì đã xảy ra không?
- Truy vấn thất bại có được phân biệt với kết quả rỗng không?
- Có thể đổi mô hình mà không đổi quy tắc nghiệp vụ không?
Nếu nhiều câu trả lời là “không”, việc chọn mô hình có lẽ chưa phải vấn đề quan trọng nhất.
NAIT xem AI là một lớp trong một hệ thống phần mềm lớn hơn. Mục tiêu là một kiến trúc nơi AI có thể mở rộng, vì dữ liệu, hành động và cơ chế kiểm soát đủ đáng tin cậy.